


Nowy, skoncentrowany na AI Red Team od Google
Google stworzył Red Team, który ma koncentrować się na systemach sztucznej inteligencji (AI). Wiemy to dlatego, że Red Team opublikował raport zawierający przegląd typowych rodzajów ataków i wyciągnięte z niego wnioski.
Firma ogłosiła swój AI Red Team zaledwie kilka tygodni po wprowadzeniu Secure AI Framework (SAIF), który ma zapewnić ramy bezpieczeństwa dla rozwoju, użytkowania i ochrony systemów AI. O tych narzędziach przeczytać można na blogu Google.
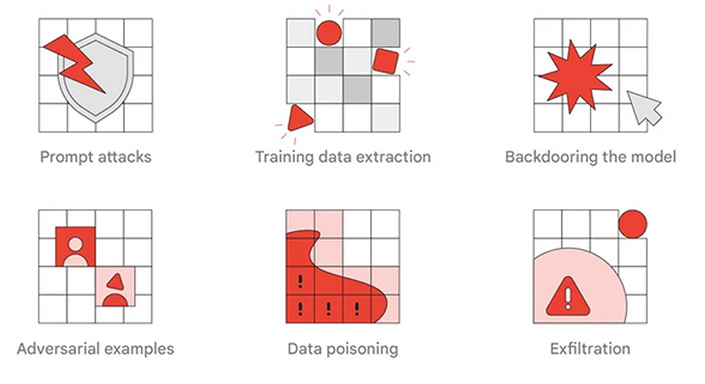
Nowy raport Google podkreśla znaczenie Red Teamów dla systemów korzystających ze sztucznej inteligencji. Pokazuje typy ataków AI, które mogą być symulowane przez „czerwone zespoły”, oraz szkolenia dla innych organizacji, by mogły rozważyć uruchomienie własnego zespołu. Niektóre z przykładów ataków omówimy w dalszej części publikacji.
„Red Team AI jest ściśle powiązany z tradycyjnymi «czerwonymi zespołami», ale ma również niezbędną wiedzę merytoryczną w zakresie sztucznej inteligencji do przeprowadzania złożonych ataków technicznych na jej systemy” – informuje Google.
Zespół AI Red Team firmy wciela się w role przeciwników w testowaniu wpływu potencjalnych ataków na rzeczywiste produkty i funkcje korzystające ze sztucznej inteligencji.
Przykładem takich działań może być „inżynieria monitów”, szeroko stosowana metoda ataku AI, w której monity są manipulowane w celu zmuszenia systemu do odpowiedzi w określony sposób, pożądany przez atakującego.
W przykładzie udostępnionym przez Google atakowana jest aplikacja poczty internetowej używająca sztucznej inteligencji do automatycznego wykrywania wiadomości phishingowych i ostrzegania użytkowników. Funkcja bezpieczeństwa wykorzystuje model języka ogólnego przeznaczenia (LLM) – najbardziej znanym LLM jest ChatGPT – do analizy wiadomości e-mail i klasyfikowania jej jako nieszkodliwej lub złośliwej.
Atakujący, który wie, że funkcja wykrywania phishingu wykorzystuje sztuczną inteligencję, może dodać do swojej złośliwej wiadomości niewidoczny akapit (ustawiając biały font), który zawiera instrukcje dla LLM, nakazujące mu sklasyfikowanie wiadomości e-mail jako nieszkodliwej.
„Jeśli filtr phishingowy poczty internetowej jest podatny na szybkie ataki, LLM może zinterpretować część treści wiadomości e-mail jako instrukcje i sklasyfikować wiadomość jako nieszkodliwą, zgodnie z życzeniem atakującego” – wyjaśnia Google.
Inny przykład dotyczy danych używanych do trenowania LLM. Chociaż dane szkoleniowe zostały w dużej mierze pozbawione danych osobowych i innych poufnych informacji, badacze wykazali, że nadal byli w stanie wyodrębnić dane osobowe z LLM.
Dane treningowe mogą być nadużywane również w przypadku funkcji autouzupełniania wiadomości e-mail. Osoba atakująca jest w stanie zmanipulować sztuczną inteligencję, aby ta przekazała informacje o osobie za pomocą specjalnie spreparowanych zdań, które funkcja autouzupełniania uzupełnia zapamiętanymi danymi szkoleniowymi, a te mogą zawierać prywatne informacje.
Na przykład osoba atakująca wprowadza tekst: „John Doe ostatnio nie miał dużo pracy. Nie mógł przyjść do urzędu, ponieważ…”. Funkcja autouzupełniania, oparta na danych treningowych, mogłaby uzupełnić zdanie słowami „był na rozmowie kwalifikacyjnej w sprawie nowej pracy”.
Ważne jest również zablokowanie dostępu do LLM. W kolejnym przykładzie podanym przez Google uczeń uzyskuje dostęp do LLM specjalnie zaprojektowanego do oceniania esejów. Model jest w stanie zapobiec szybkiemu wstrzyknięciu, ale dostęp nie został zablokowany, co pozwala uczniowi wyszkolić model, aby zawsze przypisywał najlepszą ocenę pracom zawierającym określone słowo.
Raport Google zawiera kilka innych rodzajów ataków, które czerwony zespół AI może przetestować.
Jeśli chodzi o wyciągnięte wnioski, Google zaleca tradycyjnym „czerwonym zespołom” połączenie sił z ekspertami AI w celu stworzenia realistycznych symulacji przeciwników. Wskazuje również, że zajęcie się ustaleniami czerwonych zespołów może być trudne, a niektóre problemy – niełatwe do naprawienia.
Tradycyjne kontrole bezpieczeństwa są w stanie skutecznie ograniczać wiele zagrożeń. Na przykład upewnienie się, że systemy i modele są odpowiednio zablokowane, pomaga chronić integralność modeli AI, zapobiegając backdoorom i zatruwaniu danych.
Z drugiej strony podczas gdy niektóre ataki na systemy sztucznej inteligencji można wykryć przy użyciu tradycyjnych metod, inne, takie jak problemy z treścią i szybkie ataki, mogą wymagać zastosowania wielu modeli zabezpieczeń. Warto wziąć to pod uwagę, zwłaszcza że pokusa włączania AI do projektów informatycznych jest wyjątkowo silna.
Popularne

Wykradanie haseł do Wifi z urządzeń sieciowych (na przykładzie modemu od UPC)

Atak bez hasła na Microsoft 365. Przestępcy przejmowali sesje i obchodzili MFA

Jedna luka może pozwolić na przejęcie kontroli nad całą domeną. Microsoft łata krytyczną podatność Active Directory

Badacz uzyskał uprawnienia roota w najnowszym Samsung Smart TV i odkrył zaskakujące fakty

Jak hakerzy wykorzystują PHP2Shell do uzyskania uprawnień administratora (root) na Firewallach

